LLM・RAG・生成AIの違い|AIの基礎用語をまとめて解説
AI関連の記事を読んでいると、次から次へと耳慣れない言葉が出てきます。
LLM、RAG、トークン、プロンプト、ファインチューニング。ひとつ調べるとまた別の用語が出てきて、いつまでも先に進まない...。
その原因は用語をバラバラに覚えようとしているからかもしれません。
これらの言葉には階層と関係があります。まずは全体像をつかんでみましょう。
この記事では、AIの基礎用語を「どこに位置する言葉なのか」がわかる形で整理します。
ひとつずつ覚えようとすると混乱しますよね。
これらは対等な言葉ではなく、大きい概念の中に小さい概念が入っている入れ子の関係になっています。順番に外側から見ていけば、整理しやすくなります。
目次
AI・機械学習・ディープラーニング・生成AIの関係
まず全体像を押さえます。
AI関連の用語でつまずく原因は、この4つを横並びの別物だと思ってしまうことです。
実際には、外側から順に入れ子になっています。
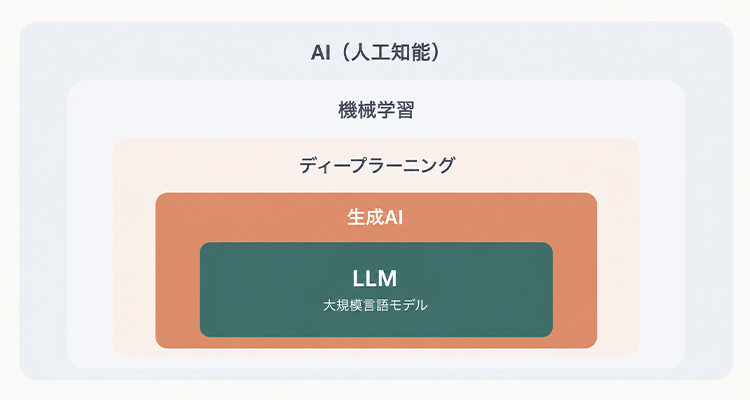
AI・機械学習・ディープラーニングの違い
AI(人工知能)
人間が行っている知的な作業を、機械にも行わせようとする技術の総称です。最も大きな枠であり、あらかじめ人がすべてのルールを書いておくタイプ(ルールベース)も含まれます。
なお、AIには確立した定義がありません。
総務省の情報通信白書でもその旨が示されており、「どこからをAIと呼ぶか」の線引きは文脈によって変わります。
機械学習
AIの一分野で、データからパターンを見つけ出す手法です。人がルールを書くのではなく、大量の事例を与えて機械自身に規則性を学ばせます。
ディープラーニング(深層学習)
機械学習の一分野です。人間の脳の神経回路をヒントにした構造を何層にも重ね、複雑なパターンを扱えるようにしたものです。画像認識や音声認識の精度が飛躍的に上がったのは、この技術によるものです。
生成AI
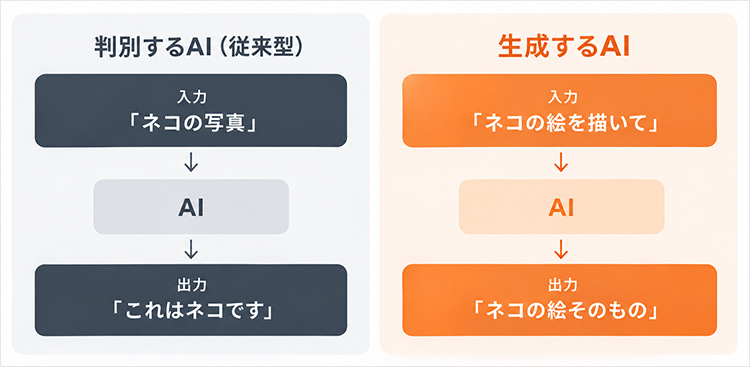
ディープラーニングを使って、新しいものを作り出すAIです。従来のAIが「これは犬か猫か」を判別していたのに対し、生成AIは文章や画像そのものを作り出します。
LLM(大規模言語モデル)
生成AIのうち、言語を扱うものです。ChatGPTやClaude、Geminiといった対話型のサービスは、いずれもLLMを中核にしています。
判別と生成の分かれ目
上記5つのなかで、性質が大きく変わるのは生成AIのところです。
従来のAI(判別するAI)
与えられたものを分類・判別する(迷惑メールかどうか、不良品かどうか)
生成AI(生成するAI)
文字通り、ないものを作り出す(文章を書く、画像を描く)
「AIが賢くなった」と言われるようになった背景には、この転換があります。同じ「ネコ」を題材にすると、入力と出力が入れ替わることがはっきりします。
LLM(大規模言語モデル)とは
LLMとは、大量の文章を学習し、言葉の並び方の規則性を身につけたAIです。Large Language Model の頭文字を取ってLLMと呼ばれます。日本語では大規模言語モデルと訳されます。
「大規模」とついているのは、学習に使う文章の量と、モデル自体の規模がきわめて大きいためです。
大量の文章を覚えているから、質問に答えられるということですか?
少し違います。LLMは文章を覚えているのではなく、次にどんな言葉が来やすいかを予測しています。ここを理解すると、AIが得意なことと苦手なことが両方説明できるようになります。
LLMは「次に来る言葉」を予測している
LLMの仕組みは、意外なほどシンプルです。与えられた文章の続きとして、次に来る可能性が高い言葉を選ぶ。この予測を積み重ねて文章を作っています。
「今日はいい」と入力されたら、次に来やすいのは「天気」だろう。「天気」の次は「ですね」だろう。この予測を1語ずつ繰り返して、文章ができあがります。
なお、次の図に示す確率の数値は、仕組みを説明するための例です。実際にどのような値になるかはモデルによって異なります。
なぜ自然な文章になるのか
「予測しているだけ」なのに人間らしい文章になるのは、学習した文章の量が桁違いだからです。
膨大な文章を読み込むなかで、単語同士のつながりやすさだけでなく、文脈に応じた言い回し、話題ごとの語彙、文章の構成の型まで、統計的な規則性として身についていきます。その結果として、意味を理解しているように見える出力が生まれます。
LLMが苦手なこと
仕組みがわかると、苦手なことも説明できます。「次に来やすい言葉」を選んでいる以上、正しさを保証する仕組みはどこにも入っていません。
事実と異なることを、自信を持って答える
もっともらしい言葉の並びであれば、内容が間違っていても出力されます。この現象はハルシネーションと呼ばれます。
学習していないことは知らない
社内文書のような非公開の情報や、学習データの締切以降のできごとは知りません。
厳密な計算や数え上げが苦手
言葉の予測をしているため、計算そのものを行っているわけではありません。桁の多い計算や、文字数を正確に数える作業は不得意です。
これらは使い方の工夫や後述するRAGといった仕組みで軽減できますが、構造上ゼロにはなりません。
出力を確認する工程は、必ず残しておく必要があります。
生成AIとLLMは何が違うのか
混同されやすいので整理しておきます。
【表1】生成AIとLLMの違い
| 項目 | 生成AI | LLM |
|---|---|---|
| 指すもの | 新しいものを作り出すAIの総称 | 生成AIのうち、言語を扱うもの |
| 扱う対象 | 文章・画像・音声・動画・コード | 主に文章 |
| 関係 | LLMを含む上位の概念 | 生成AIの一種 |
| 使われ方 | 分野全体を指すときに使う | 技術的な話をするときに使う |
生成AIのほうが広い言葉です。画像生成AIも音声生成AIも生成AIですが、LLMではありません。
ただし実務では、この2つがほぼ同じ意味で使われる場面もあります。対話型のサービスが生成AIの代表格になっているためです。厳密に使い分ける必要はありませんが、包含関係は知っておくと話が通じやすくなります。
押さえておきたい基本用語
ここからは、実際の会話やドキュメントで頻出する用語を整理します。すべてを暗記する必要はありません。出てきたときに戻って確認できれば十分です。
【表2】生成AIの基本用語
| 用語 | 意味 | ひとことで言うと |
|---|---|---|
| プロンプト | AIへの指示・質問として入力する文章 | AIへの指示書 |
| コンテキスト | AIが一度に考慮できる情報の範囲 | AIの作業机の広さ |
| トークン | AIが文章を処理する際の最小単位 | 文章を刻んだかけら |
| パラメータ | モデルの内部で調整される数値 | AIの頭脳の複雑さの目安 |
| ハルシネーション | 事実と異なる内容を生成する現象 | もっともらしい誤り |
| マルチモーダル | 文章以外も扱えること | 目や耳を持つAI |
プロンプト
AIに与える指示や質問のことです。同じAIでも、プロンプトの書き方で出力の質は大きく変わります。
「わかりやすく書いて」より「高校生にもわかるように、専門用語を使わず500字で書いて」のほうが、意図に近い結果が返ってきます。条件を具体的に伝えることが基本です。
コンテキスト
AIが一度に考慮できる情報の範囲を指します。会話の履歴や、読み込ませた資料がここに入ります。
作業机の広さに例えるとわかりやすくなります。机が広ければ多くの資料を同時に広げて考えられますが、狭ければ古い資料から片付けていくことになります。長い会話を続けると最初のほうの話を忘れてしまうのは、これが理由です。
トークン
AIが文章を処理するときの最小単位です。文章を単語やそれより細かい単位に分けたものを指します。分け方はサービスによって異なりますが、日本語では1文字あたり1〜2 トークン程度が目安です。
コンテキストの上限やAPIの料金は、このトークン数を基準に決まります。「文字数」ではなく「トークン数」で数えられていると覚えておけば十分です。
パラメータ
モデルの内部で調整されている数値のことです。数が多いほど複雑な表現を学習できるとされますが、多ければ必ず優秀というわけではありません。学習データの質や設計によって性能は変わります。
ハルシネーション
事実と異なる内容を、もっともらしく生成してしまう現象です。幻覚を意味する英語から来ています。
前述のとおり、LLMが「次に来やすい言葉」を選ぶ仕組みである以上、構造的に起こりうるものです。実在しない書籍名や、存在しない条文を答えることがあります。
マルチモーダル
文章だけでなく、画像・音声・動画なども扱えることを指します。写真を見せて内容を説明させる、音声で指示を出すといった使い方が該当します。
近年の主要なサービスは、LLMを土台にしながら画像や音声も扱えるようにしたものが主流です。本記事で整理した「LLM=言語を扱うもの」という位置づけは、あくまで言葉の出発点として押さえておくとよいでしょう。
もう一歩進んだ用語
ここからは、業務でAIを活用する話になると出てくる用語です。
基礎用語より一段実務寄りですが、意味を知っておくと会議で話が追えるようになります。
RAG(検索拡張生成)
生成AIが回答を作る前に、外部の資料を検索して読み込ませる仕組みです。
LLMは社内の情報を知りません。そこで、質問のたびに社内文書などの手元の資料を探し出し、それを渡したうえで答えさせます。AI自体を作り替えるのではなく、その都度、資料を手渡しているイメージです。
社内ヘルプデスクや、規程・マニュアルの検索といった用途で使われています。
ファインチューニング(追加学習)
モデル自体に追加の学習をさせて、振る舞いを調整することです。
RAGと混同されやすいのですが、目的が違います。RAGは知識を与えるもの、ファインチューニングは答え方を変えるものです。自社独自の言い回しや、決まった形式での出力を徹底させたい場合に使われます。
情報を持たせたいならRAG、振る舞いを変えたいならファインチューニング。この切り分けを覚えておけば、選択を誤りません。
AIエージェント
指示を受けて、複数の手順を自律的に実行するAIです。
従来の生成AIが「聞かれたら答える」のに対し、AIエージェントは「任せられたら動く」。調べる、まとめる、外部のツールを操作するといった作業を、順番に自分で進めていきます。
用語からたどるAIの進化
用語の関係がわかると、AIがどう発展してきたかも見えてきます。それぞれの用語は、その時々の課題を解くために生まれました。
おおまかな流れとして整理すると、次のようになります。
| 段階 | 課題 | 生まれたもの |
|---|---|---|
| ルールを人が書く時代 | 例外に対応できない | 機械学習 |
| データから学ぶ時代 | 複雑なパターンを扱えない | ディープラーニング |
| 判別が得意になった時代 | 判別はできるが作れない | 生成AI |
| 文章を作れる時代 | 社内のことを知らない | RAG |
| 質問に答えられる時代 | 答えるだけで動かない | AIエージェント |
※厳密な年表ではなく、「どんな課題からその言葉が生まれたか」で並べた整理です。
こうして並べると、新しい用語は前の段階の限界から生まれていることがわかります。
今後も新しい言葉が次々に登場しますが、「それは何の課題を解こうとしているのか」を問えば、位置づけをつかめます。用語を追いかけるより、この視点を持っておくほうが長く役に立ちます。
用語をおさえるコツ
ここまで読んで整理はできましたが、全部覚えられる自信がありません。
覚えられなくても大丈夫ですよ。
大事なのは「どのあたりの話をしているか」がわかることです。細かい意味は都度調べれば済みます。
覚えるべきものと、そうでないもの
| 覚えておくべきもの | 都度調べればよいもの |
|---|---|
| 用語同士の階層関係 | 個々の用語の厳密な定義 |
| 生成AIが得意なこと・苦手なこと | モデル名やバージョン番号 |
| RAGとファインチューニングの違い | パラメータの具体的な数値 |
| ハルシネーションが起こる理由 | 各社の最新機能 |
右側は数か月で入れ替わります。 追いかけても消耗するだけです。
左側は数年単位で変わりません。ここに理解を集中させるのが、最も効率のよい学び方です。
次に何を学ぶか
用語の全体像がつかめたら、次は目的に応じて分岐します。
業務で使いたい
実際にツールを触りながら、プロンプトの書き方を身につける
社内で推進したい
RAGや導入時のリスクなど、実装に近い知識へ進む
体系的に学びたい
資格試験を目標にすると、範囲が明確になり学習が進めやすくなります
おわりに
AIの用語がわかりにくいのは、内容が難しいからではありません。バラバラに覚えようとすると、いつまでも全体像が見えないからです。
- AI・機械学習・ディープラーニング・生成AI・LLMは、外側から順に入れ子になっている
- LLMは「次に来る言葉」を予測している。それが得意なことも苦手なことも決めている
- ハルシネーションは仕組み上起こりうるため、確認の工程は必ず残す
- 生成AIはLLMを含む上位の言葉 ※厳密な使い分けより包含関係を押さえる
- 新しい用語は「何の課題を解くために生まれたか」で位置づけられる
大切なのは、 用語を追いかけるのではなく「全体像を押さえておくこと」です。これができていれば、新しい言葉が出てきても慌てずに済みます。
インターネット・アカデミーでは、AI・生成AIを体系的に学べる講座をご用意しています。用語の理解にとどまらず、実務での活用まで学べる内容です。まずはお気軽に無料体験レッスン・カウンセリングにお越しください。
相談してコースを選びたい方はカウンセラーに無料で相談
※無理な勧誘は一切ありません
 無料で相談してみる


LLMとかRAGとか、似た言葉が多くて頭に入ってきません......。