RAGとは?社内データを生成AIに読ませる仕組みをわかりやすく解説
- ツイート
-
- 2026/10/27
「RAG(ラグ)」という言葉を、会議や記事で見かけるようになりました。 生成AIを業務に組み込もうとするとき、ほぼ必ず登場する言葉です。
RAGがやろうとしているのは、ひとことで言えば 「AIに社内の資料を読ませてから答えさせる」こと。 自社の就業規則も、製品マニュアルも、過去の議事録も、 AIは元から知っているわけではないからです。
この記事では、RAGとは何か、どういう仕組みで動くのか、そして似た手法との違いや導入時の注意点までを、専門知識がない方にもわかるように解説します。
いいえ、AIの種類ではありません。RAGは「AIに社内の情報を読ませてから答えさせる」ための仕組みです。AIそのものを作り替えるわけではない、という点がいちばんの特徴です。
目次
RAGとは
RAGとは、生成AIが回答を作る前に、外部にある情報を検索して読み込ませる仕組みです。
AIが元から持っている知識だけで答えるのではなく、その都度、必要な資料を手渡してから答えてもらう、というイメージが近いでしょう。
人間に置き換えると理解しやすくなります。社内規程について質問されたとき、記憶だけで答える人と、手元の規程集を開いて該当箇所を確認してから答える人がいます。RAGは後者のやり方をAIにさせるための仕組みです。
RAGの正式名称と読み方|検索拡張生成とは
RAGは「Retrieval-Augmented Generation」の略で、日本語では検索拡張生成と訳されます。読み方は「ラグ」です。
3つの単語がそのまま仕組みを表しています。
- Retrieval(検索):必要な情報を探してくる
- Augmented(拡張):探してきた情報でAIの知識を補う
- Generation(生成):補われた状態で回答を作る
「検索してから生成する」という順序が、この仕組みの本質です。
なぜRAGが必要とされるのか
生成AIの中核にあるLLM(大規模言語モデル)は、学習した膨大なテキストをもとに回答を作ります。この仕組みには、業務利用における弱点が3つあります。
1つ目は、社内の情報を知らないこと。 学習しているのは公開された情報が中心なので、自社の規程や顧客情報、過去のやり取りといった非公開の情報には一切アクセスできません。
2つ目は、知識に締切があること。 LLMには学習データの締切があり、それ以降に起きたことはわかりません。最新の制度変更や、先月改訂された社内ルールには対応できないのです。
3つ目は、知らないことでも答えてしまうこと。 LLMは「わからない」と言うより、それらしい文章を作ってしまう傾向があります。事実と異なる内容を自信を持って答える現象は「ハルシネーション」と呼ばれます。
RAGは、この3つの弱点に同時に効きます。社内文書を読ませることで1つ目が、最新の資料を読ませることで2つ目が、根拠となる文書を明示させることで3つ目が、それぞれ緩和されるからです。
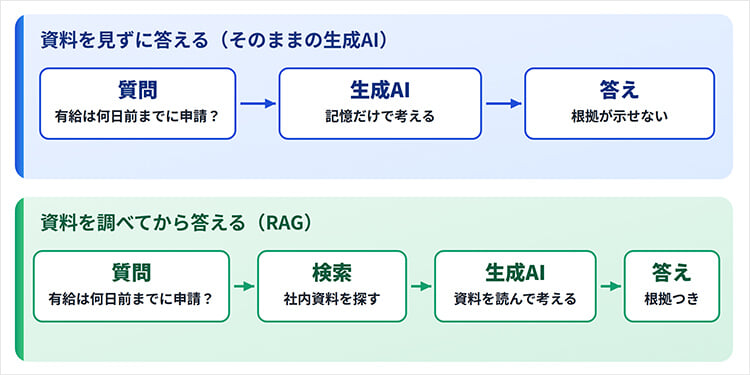
同じ質問を投げたとき、RAGがある場合とない場合では、返ってくる答えがまったく変わります。
RAGの仕組みは「準備」と「毎回」の2段階
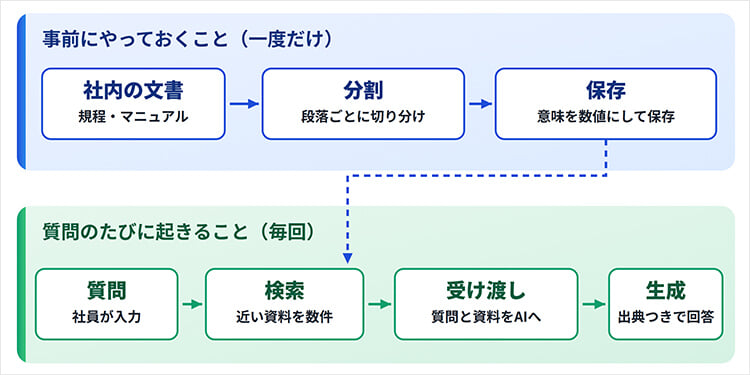
RAGの処理は、事前に一度だけやっておくことと、質問のたびに毎回起きることの2段階に分かれています。
ここを混ぜて理解してしまうと、「質問するたびに社内文書を分割し直しているのか」という誤解が生まれます。実際の現場でもよく起きる勘違いです。まず、この2段階の区別から押さえてください。
事前準備:社内文書を分割して保存する
RAGを使い始める前に、一度だけ行っておく作業になります。
PDF、Word、社内Wiki、議事録など、対象となる文書を集めて、適度な長さのかたまりに分割します。1つの文書をまるごと扱うと情報量が多すぎるため、章や段落といった単位に切り分けるのが一般的です。
分割した文書は、意味を数値で表現した形に変換して保存します。この変換によって、単語が完全に一致していなくても「意味が近い文書」を探せるようになります。「有給休暇」で検索したときに「年次有給休暇の付与」と書かれた文書が見つかるのは、この仕組みのおかげです。
ここまでが準備です。以降の3つは、質問が入るたびに毎回繰り返されます。
毎回① 質問に近い資料を探す
ユーザーが質問を入力すると、その質問文も準備段階と同じように数値化されます。そして、保存しておいた文書群の中から、意味的に近いものを上位数件だけ取り出します。
ここで重要なのは、すべての文書を渡すわけではないという点です。AIが一度に読み込める分量には上限があるため、関連性の高いものだけを選び抜く必要があります。この「選び抜く精度」が、RAG全体の品質を大きく左右します。
毎回② 質問と資料をまとめてAIに渡す
取り出した文書と、ユーザーの質問を組み合わせて、AIへの指示を組み立てます。
実際には、「以下の資料を参考にして質問に答えてください」という趣旨の指示文に、資料本文とユーザーの質問を差し込む形になります。ここで「資料に書かれていないことは答えないでください」といった条件を加えることで、AIが勝手に推測して答えるのを抑えられます。
毎回③ AIが資料を読んで答える
最後の段階です。 AIが渡された資料を読んだうえで回答を生成します。
このとき、参照した文書名やページ番号を一緒に出力させる設計にしておくと、利用者が回答の根拠を確認できます。根拠が示されることは、業務利用において精度そのものと同じくらい重要です。誤りに気づける状態を作れるからです。
改めて要点をまとめると、AIの中身は一切変わっていません。毎回その場で資料を手渡しているだけ、という点が理解の要になります。
RAGを組み込んだAIが、さらに自律的に動作するようになった形が「AIエージェント」です。
改めて要点をまとめると、AIの中身は一切変わっていません。毎回その場で資料を手渡しているだけ、という点が理解の要になります。
RAGとファインチューニングの違い
社内データを覚えさせるなら、AIを追加学習させたらいいんじゃないかな?
それがファインチューニングという手法です。ただし、RAGとは目的が違います。ファインチューニングはAIの「答え方」を変えるもので、RAGはAIに「知識」を渡すもの。混同すると、選択を誤ります。
社内データを扱う方法として、RAGとよく比較されるのがファインチューニング(追加学習)です。両者は似た文脈で語られますが、性質はかなり異なります。
【表1】RAGとファインチューニングの比較
| 観点 | RAG | ファインチューニング |
|---|---|---|
| やること | 回答時に外部の資料を読ませる | AI自体を追加学習させる |
| 得意なこと | 知識を与える | 答え方や文体を整える |
| 情報の更新 | 元データを差し替えるだけ | 再学習が必要 |
| 導入コスト | 比較的低い | 高い |
| 専門人材 | 一般的な開発知識で対応可能 | 機械学習の知見が必要 |
| 根拠の提示 | できる | 難しい |
| 向くケース | 社内規程・マニュアルの参照 | 独自の言い回しや形式の統一 |
どちらを選ぶべきか
判断の軸はシンプルです。
「情報を持たせたい」ならRAG。 社内の資料を参照して答えてほしい、最新の内容に追従してほしい、根拠を示してほしい。これらはすべてRAGの領域です。
「振る舞いを変えたい」ならファインチューニング。 自社独自の言い回しで書いてほしい、決まったフォーマットで必ず出力してほしい。こうした要求は追加学習が向きます。
多くの企業がまず直面するのは前者の課題です。そのため、業務導入の入口としてはRAGから検討するのが一般的になっています。両方を組み合わせる構成もありますが、最初から欲張る必要はありません。
RAGでできること・できないこと
期待値を正しく持つために、RAGの守備範囲を整理しておきます。
【表2】RAGでできること・できないこと
| できること | できないこと |
|---|---|
| 社内文書にもとづいて回答させる | 元データにない情報を答える |
| 最新の資料に追従させる | 誤りを完全になくす |
| 回答の根拠を示させる | 文体や口調を根本から変える |
| 部署ごとに参照範囲を分ける | 資料の矛盾を自動で解決する |
| 情報の追加・削除を即座に反映する | 整理されていない情報を整理する |
とくに誤解が生まれやすいのが右側の最後の項目です。RAGは、情報を整理してくれる仕組みではありません。 散らかった文書をそのまま読ませれば、散らかった答えが返ってきます。元の情報が整っていることが前提になります。
RAGの活用例
実際に企業でどう使われているのか、代表的な3つのパターンを紹介します。
社内ヘルプデスク・問い合わせ対応
情報システム部門や総務部門には、同じような質問が繰り返し寄せられます。パスワードの再設定手順、備品の申請方法、経費精算のルール。いずれも社内文書に答えが書かれているものです。
RAGを使った問い合わせ窓口を用意すれば、担当者が対応する前に多くの質問が解決します。回答に参照元の文書名が添えられていれば、利用者は自分で原本を確認することもできます。
社内規程・マニュアルの検索
規程やマニュアルは、量が多く、必要な箇所を探すのに時間がかかります。しかも「どのキーワードで探せばいいかわからない」という状態になりがちです。
RAGは意味の近さで検索するため、利用者が正確な用語を知らなくても該当箇所にたどり着けます。「子どもが生まれたときの手続き」と入力すれば、育児休業に関する規程が見つかる、といった具合です。
カスタマーサポート
製品仕様やFAQ、過去の対応履歴を参照させることで、オペレーターの回答作成を支援できます。新人でも過去の蓄積にアクセスできるため、対応品質のばらつきを抑える効果も期待できます。
ここで挙げた3つに共通しているのは、「答えは社内にあるが、探すのに手間がかかる」という課題です。この形の課題を抱えているなら、RAGは有力な選択肢になります。
RAGを導入するときの注意点
導入がうまくいかないケースには、いくつか共通した原因があります。
元データの品質が精度を決める
RAGの精度を決めるのは、AIの性能よりも元となる文書の状態です。
古い版と新しい版が混在している、同じ内容が複数の場所に別々の表現で書かれている、そもそも文書化されておらず担当者の頭の中にしかない。こうした状態のまま導入すると、AIは矛盾した情報を読んで矛盾した答えを返します。
導入プロジェクトの実務時間の多くが、AIの設定ではなく文書の棚卸しに費やされるのはこのためです。逆にいえば、この整理は将来AIを使わなくなっても無駄になりません。
アクセス権限の設計
全社員が全文書を参照できてよい、というケースはまずありません。人事情報、給与、経営情報、部門固有の機密。これらが誰でも引き出せる状態になると、深刻な情報漏えいにつながります。
「誰がどの文書を参照できるか」を、AI導入前に整理しておく必要があります。 権限設計は後から足すのが難しい領域なので、設計段階で組み込んでおくべき論点です。
ハルシネーションはゼロにならない
RAGはハルシネーションを減らす仕組みであって、なくす仕組みではありません。
関連する文書が見つからなかったとき、AIは手持ちの知識で答えを作ろうとします。また、渡された資料を誤って解釈することもあります。
重要な判断に使う場面では、人が確認する工程を必ず残してください。 回答に根拠を表示させる設計にしておくのは、この確認を現実的にするためでもあります。
RAGを学ぶには何から始めるか
非エンジニアでも、RAGは理解しておいたほうがいいのかな?
はい。自分で実装できなくても構いません。仕組みを知っていれば、「この業務にはRAGが向く」「この課題はRAGでは解決しない」という判断ができます。それだけで、社内での議論の質が変わります。
RAGを扱えるようになるための道筋は、立場によって変わります。
業務側の担当者であれば、まず仕組みの理解と、自社データの棚卸しから。 どの文書を、どの範囲の人に、どう参照させたいのか。これを言語化できることが、外部ベンダーや情報システム部門と話すための最低条件になります。技術を学ぶ前に、要件を書ける状態を目指すのが近道です。
実装まで担うなら、順序があります。 生成AIとLLMの基礎、プログラミング(Pythonが標準的)、テキストデータの扱い、そして検索の仕組み(とくに、意味の近さで探す仕組み) 。RAGは複数の技術の組み合わせなので、土台となる知識がないまま部分的に触っても応用が効きません。
いずれの立場でも、AI全体の基礎を体系的に押さえておくと理解の速度が大きく変わります。断片的に用語を覚えるより、AI・機械学習・ディープラーニング・生成AIの関係を一度整理したほうが、結果的に早く到達できます。
おわりに
RAGは、生成AIを「一般的なことしか答えられない道具」から「自社のことを踏まえて答えられる道具」に変えるための仕組みです。
要点を整理します。
- RAGは、回答前に外部の資料を検索して読ませる仕組み(検索拡張生成)
- AI自体を作り替えるのではなく、その都度、資料を手渡している
- 知識を与えたいならRAG、振る舞いを変えたいならファインチューニング
- 精度を決めるのは、AIの性能より元データの状態
- ハルシネーションは減らせるが、ゼロにはならない
生成AIの業務活用が進むほど、こうした仕組みを理解している人材の価値は高まります。実装まで担うかどうかにかかわらず、仕組みを説明できる状態を目指しておくことをおすすめします。
AI知識を有効にビジネス活用する
生成AIコースAI技術とは何か、生成AIをビジネス活用する上で必要な知識を体系的に網羅して学ぶコースです。生成AIに代表されるChatGPTや画像・動画生成の活用法はもちろん、ビジネスに活用するうえでの失敗事例やリスクとその対処法までを学ぶことができます。
インターネット・アカデミーの「生成AI活用講座」では、RAGの仕組みと利点・欠点、ファインチューニングとの違いまでを、カリキュラムとして体系的に学べます。
さらに実際に手を動かしたい方は、自社データを読み込ませたAIアシスタントを構築する「生成AI活用実践講座」もご用意しています。プログラミングの知識は不要です。
まずはお気軽に無料体験レッスン・カウンセリングにお越しください。
相談してコースを選びたい方はカウンセラーに無料で相談
※無理な勧誘は一切ありません
 無料で相談してみる


RAGって、AIの新しい種類なのかな?